2026 年 9 月 8 日,OpenAI 发布 GPT Image 2.5。热闹的说法是「更快、更清晰、更强」
但把发布说明和第三方实测摆到一起看,最该记住的是:
它把原来的单模型拆成了 Flare 和 Sunburst 两个,真正的升级藏在多轮编辑里,不在你随手出的那一张图上。
作者 | 听风
编辑/排版 | MM77
翠鸟AI技术漫研 — 拓新AI边界、探索技术增量
2.5 最大的结构变化是 OpenAI 把「一个模型」拆成了「快车道 Flare + 精修道 Sunburst」,画质本身反倒是次要的
它的真实增量集中在多轮编辑一致性和最多 16 张参考图——如果你的活儿是反复改同一张图,这是实打实的升级;
如果你只是一次性出单图,那这次更像换了台更省油的车,好开的程度差不多。
01. 先看清楚:2.5 不是一个模型
过去 GPT Image 2 是一个模型,你调它、给个质量档位,它出图。
2.5 变了:
在 API 里它是两个独立模型——gpt-image-2.5-flare 和 gpt-image-2.5-sunburst,各有各的 model id,不是一个模型的两个开关。
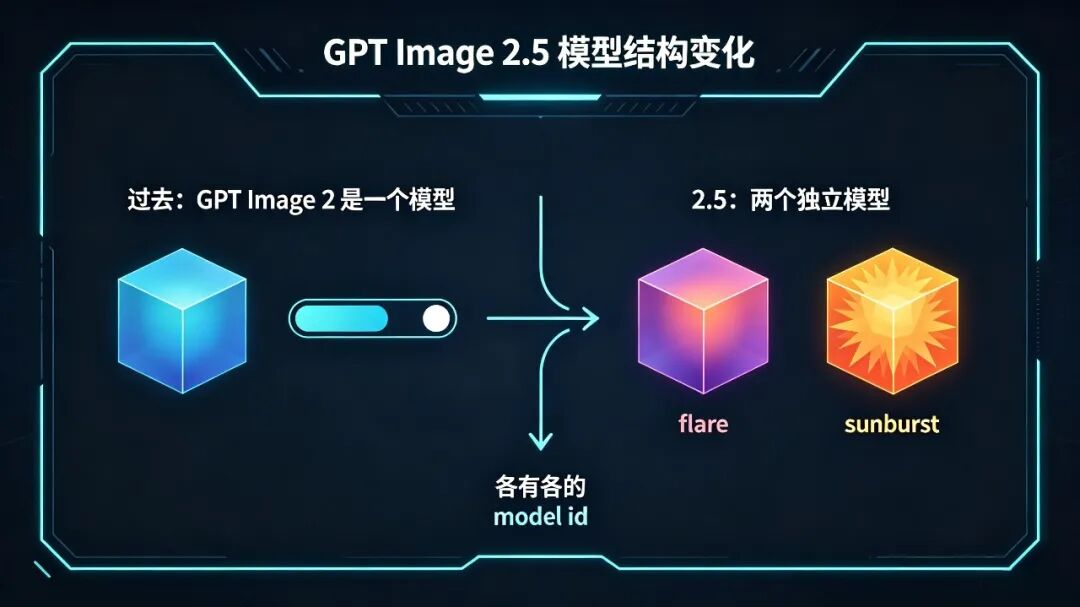
这点容易被"版本号 +0.5"的错觉盖住。
很多人以为 2.5 就是 2.0 调好了参数跑得快一点。实际发生的是分工:
- Flare——默认款,快车道。
- OpenAI 给它的定位是"质量、编辑能力、速度的平衡",延迟比 2.0 低最多一半,适合绝大多数生产场景。
- Sunburst——精修道。
- 为需要更高编辑精度、更强控制力的高端创意工作准备,代价是出图更慢。
官方特意澄清过一个容易搞错的点:
Flare 不是 Sunburst 里的一个低质量档,把 Sunburst 拉到 max 质量也不会让它变成 Flare。
两者是并列的模型,共享同一套质量档位,内核却是两套。
所以选哪个得在动手前定下来,不能指望事后调参补救。
OpenAI 嘴上讲的是"更快了",手里真动的,是把速度和编辑拆给两个模型各背一摊。
02. 逐项对照:从 2.0 到 2.5 具体动了哪些
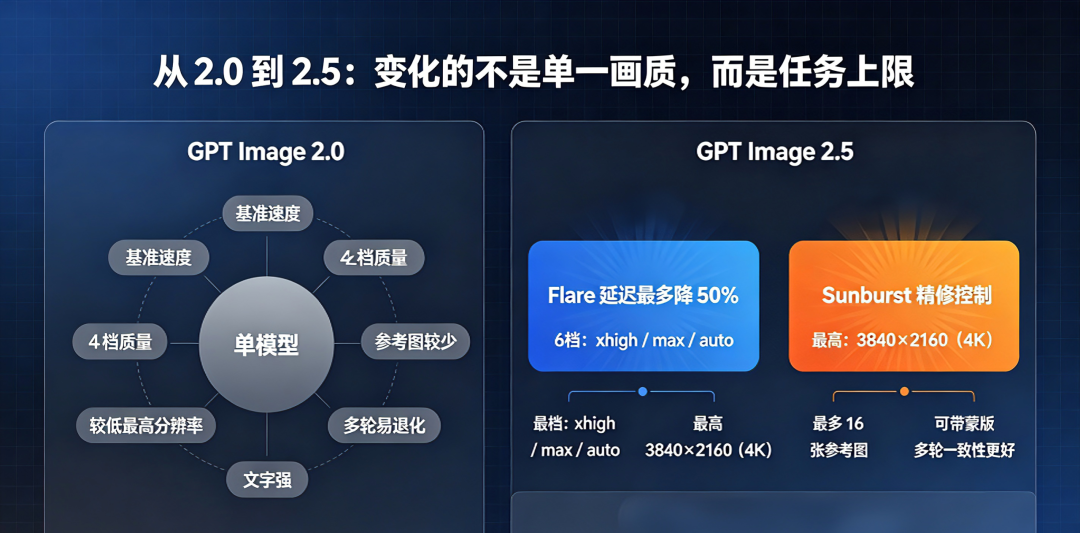
| 维度 | GPT Image 2.0 | GPT Image 2.5 |
| 模型形态 | 单模型 | Flare(快)+ Sunburst(精),两个独立 id |
| 速度 | 基准 | Flare 延迟最多降 50%(第三方实测更激进) |
| 质量档位 | 4 档,到 high 为止 | 6 档,新增 xhigh / max(+auto) |
| 最高分辨率 | 较低 | 最高 3840×2160(4K) |
| 参考图(编辑) | 较少 | 单次最多 16 张,可带蒙版 |
| 多轮编辑一致性 | 多轮后易退化 | 改一处、其余不乱,长对话里前面的改动能保持 |
| 透明背景 | 支持 | 原生支持 |
| 文字渲染 | 已很强(99% 字符级) | 与 2.0 持平,非质变 |
| token 单价 | 图输出 $30/1M | 未涨,与 2.0 相同 |
把这张表读进去,会发现真正"新"的东西其实就两块:
编辑相关的能力(多轮一致性、16 张参考图、蒙版)和档位/分辨率的上限(xhigh、max、4K)。
单张图从零生成的裸画质,第三方测下来提升有限,复杂结构化任务(比如画流程图)仍会犯 2.0 那些老错。
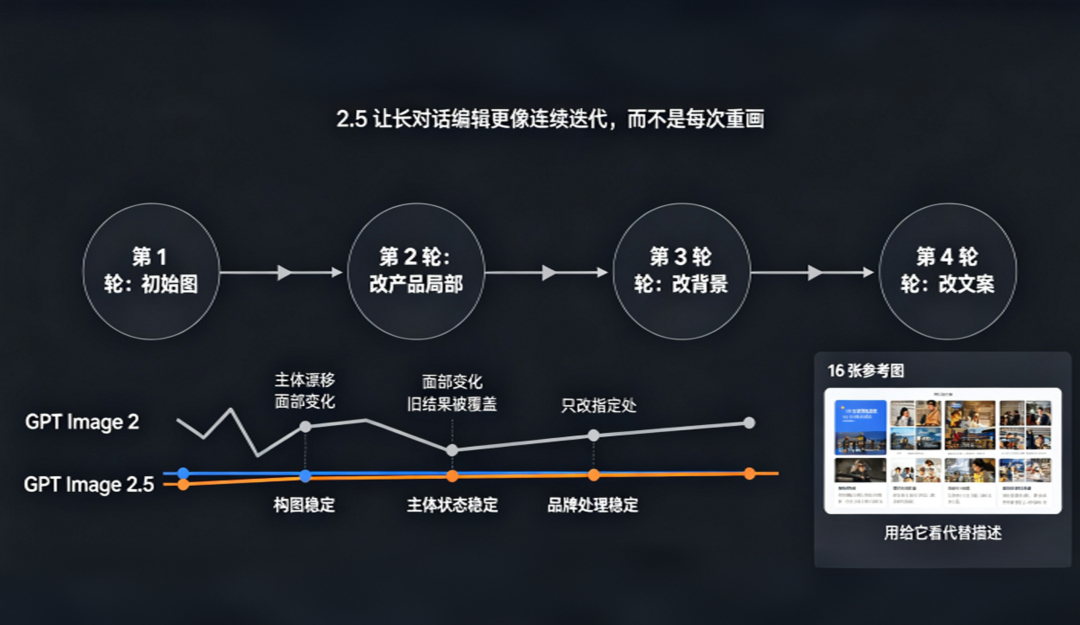
多轮编辑一致性——这次真正的主升级
这是各家实测里被反复点名的一点。
以前用 GPT Image 2 反复改同一张图,改到第三四轮,主体会漂、脸会变、之前调好的地方会被新指令带崩。
2.5 的改法是:
你改一个产品、一处背景、一行文案,周围的构图、品牌处理、主体状态基本原样保留;
长对话里每一次编辑是在上一次的结果上叠加,而不是从头重画一遍。
对逐帧、逐步迭代的工作来说,这带来的是连贯性——第三方形容为"帧间抖动明显减少"。
画风没什么新的,变好的是"一连串编辑"这件事本身,以前它基本不可用。
搭配单次 16 张参考图,你可以用"给它看"代替"跟它描述",一致性才真正落地。
03. 价格这块,别被"Flare 更快=更便宜"骗了
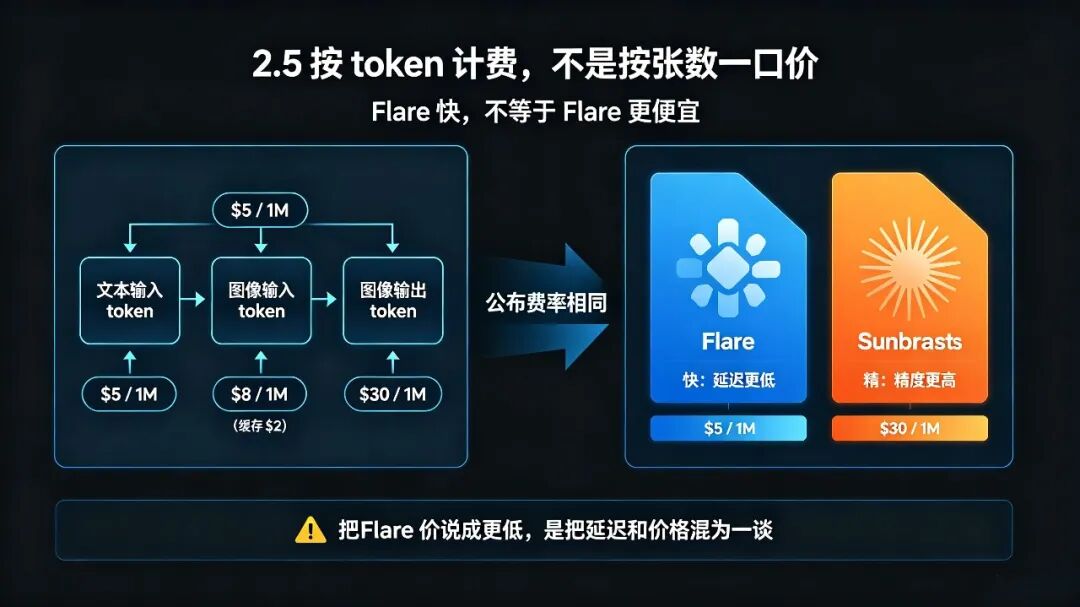
2.5 的计费是按 token 算,不是每张图一口价。
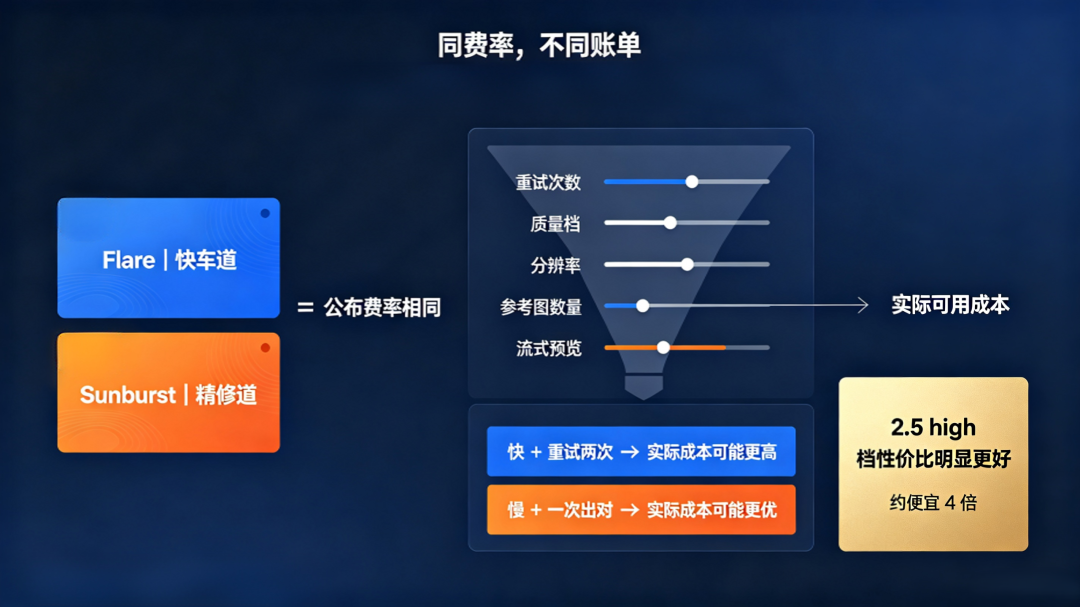
截至发布,Flare 和 Sunburst 公布的是同一套费率:
文本输入 $5/1M、图像输入 $8/1M(缓存 $2)、图像输出 $30/1M。这套价格相比 2.0 没有变动。
⚠️ "Flare 是快车道,所以更便宜"——这是把延迟当成了价格。
费率表上 Flare 和 Sunburst 一模一样,谁报给你一个更低的"Flare 价",多半是把两码事混了。
真正决定账单的是每张"能用的图"的成本:
重试次数、质量档、分辨率、参考图数量、是否开流式预览。
两个模型可以共用同一张费率表,一旦把废片算进去,实际花销就分岔了——一个快但要重试两次的模型,可能比一个慢但一次就出对的模型更贵。
有一个实打实的降本点值得记:
2.5 的 high 档用的是 2.0 medium 档的 token 预算,同等输出下大约便宜 4 倍。
也就是说,同样要"高质量",2.5 在这一档上性价比明显更好。
单张 1024×1024 的估算成本区间大致从 low 档约 $0.006 到 max 档约 $0.211。
04. 那到底该不该升?按你的活儿分
把上面的事实收敛成一条判断路径,比笼统说"值得升"有用得多。
核心变量只有一个:
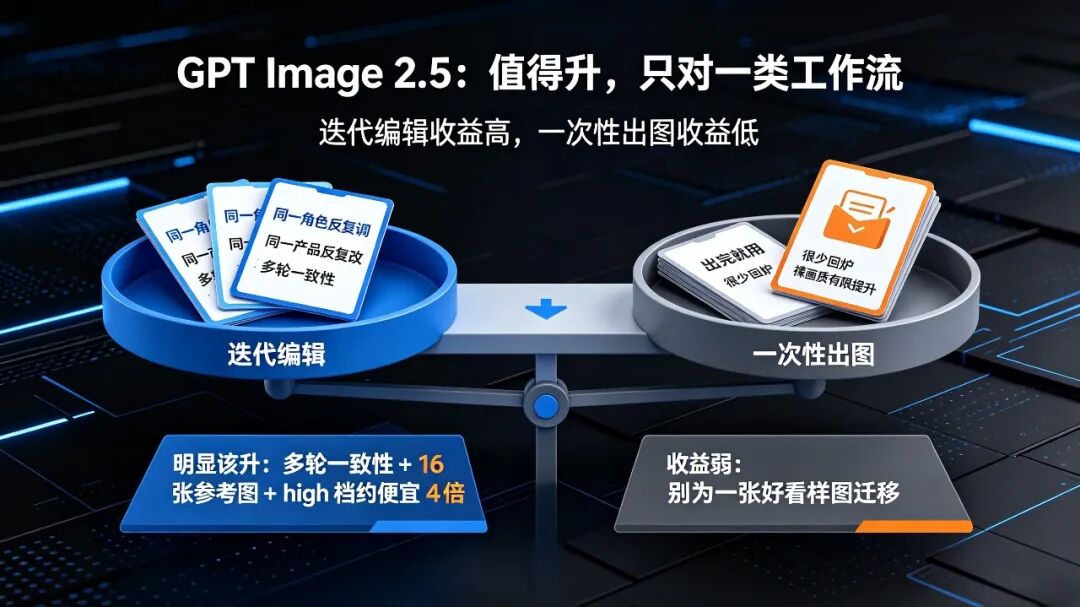
你是在反复改同一张图,还是一次性出新图。
✓ 明显该升
你的工作是迭代编辑——同一个角色/产品/画面要反复调整,需要多轮之间保持一致,或者手头有多张参考图想一起喂进去。
2.5 的多轮一致性和 16 张参考图就是冲这个来的,收益直接。high 档降本 4× 也顺带省钱。
— 升级收益弱
你主要是一次性出单图,出完就用、很少回炉。
2.5 的裸画质相比 2.0 提升有限,而编辑操作在 2.0 上本来就和 Flare 一样快——速度红利只体现在"新生成"。
这种情况下升不升差别不大,别为一张好看的样图就迁移。
还有一层容易被忽略:
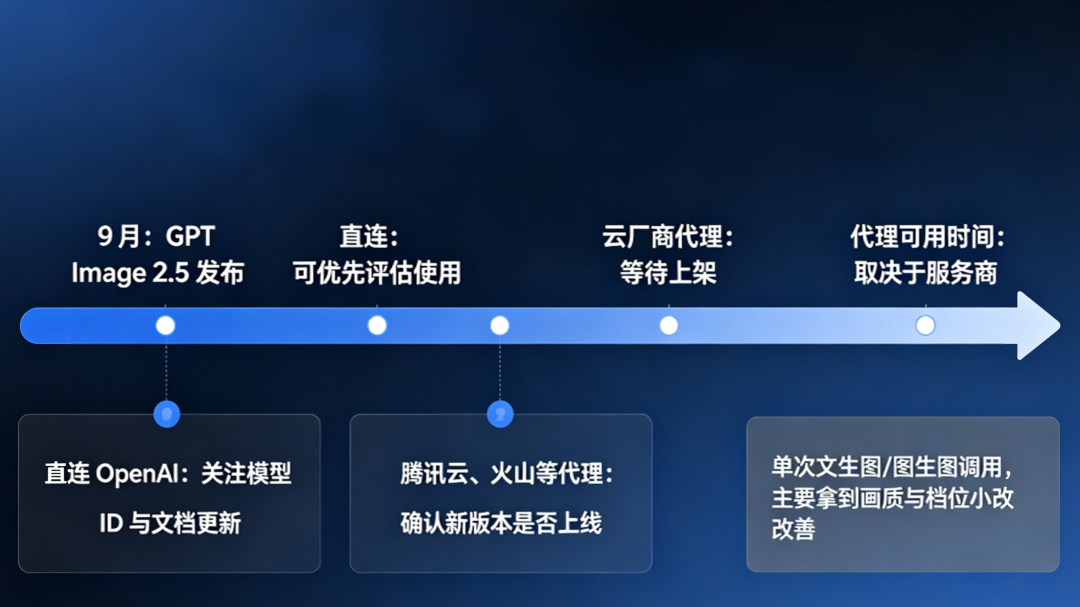
你是直连 OpenAI,还是通过云厂商代理在用?
如果是走腾讯云、火山这类中间层,2.5 能不能用、什么时候能用,取决于代理方有没有把新版本上架——GPT Image 2.5 是 9 月才发的,代理层通常会滞后。
更关键的是,如果你的调用是单次文生图/图生图、没有走多轮编辑会话,那 2.5 那个"最大卖点"你在架构上就吃不到,拿到的主要是画质和档位的小改善。
几乎所有第三方评测都落到同一句话上,这也是最稳的做法:
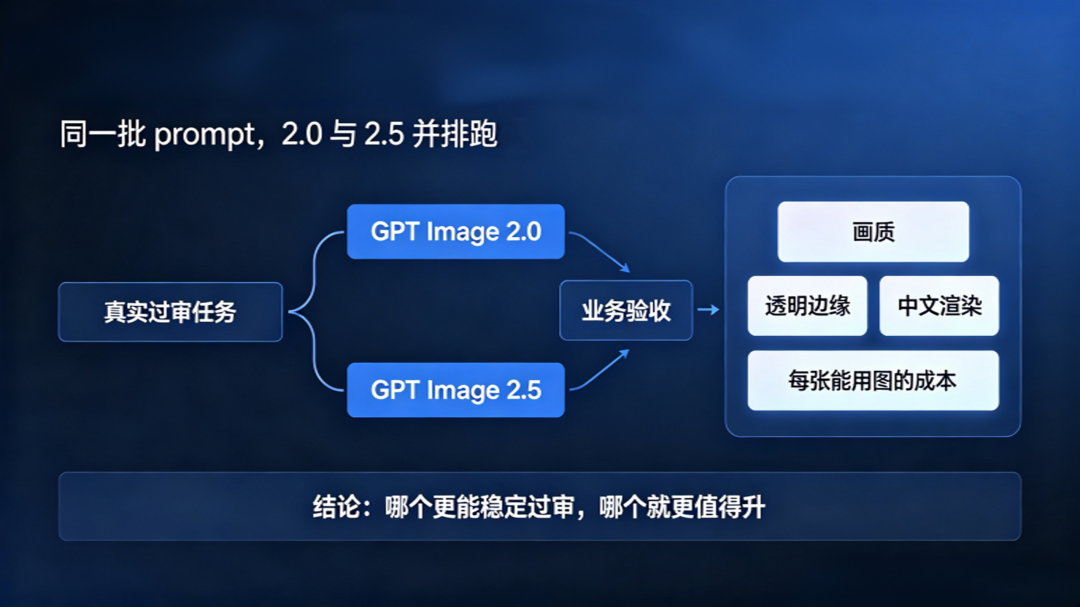
拿你团队真实要过审的那类活儿,同一批 prompt 在 2.0 和 2.5 上各跑一遍,比对你真正在乎的细节——画质、透明边缘、中文渲染、每张能用图的成本——再决定。
一张打磨过的官方样图说明不了什么。
带走这张表
反复改同一张 → 升,为多轮一致性和 16 张参考图。
一次性出单图 → 可升可不升,画质提升有限。
走云厂商代理 → 先确认代理层上没上 2.5,再谈升级。
不管哪种 → 拿真实活儿跑 A/B,看"每张能用图"的成本,别看样图。